Bagian dari skripsi Pemodelan Simpanan Karbon Mangrove Berbasis Citra Sentinel 2A di Muara Sungai Cipunegara, Subang, Jawa Barat · Daftar isi
3.1 Desain Penelitian
Penelitian ini menggunakan metode dekskriptif kuantitatif dengan pendekatan penginderaan jauh dan analisis statistik yang dilakukan menggunakan komputasi awan (cloud computing) untuk membangun model penduga karbon di atas permukaan (Above Ground Carbon) hutan mangrove di muara sungai Cipunegara, Desa Patimban, Kabupaten Subang. Analisis spasial dilakukan menggunakan citra Sentinel-2 Surface Reflectance melalui Google Earth Engine (GEE) dengan tahapan cloud masking berbasis algoritma CS + (Cloud Score Plus) serta klasifikasi tutupan mangrove menggunakan algoritma RF (Random Forest) . Data lapangan berupa DBH mangrove yang digunakan untuk menghitung biomassa melalui model alometrik. Hasil pengukuran karbon di lapangan dan nilai indeks vegetasi kemudian digunakan sebagai variabel dalam model regresi linier terbimbing, yang bertujuan untuk membangun persamaan pendugaan AGC. Selanjutnya, tingkat akurasi model diuji menggunakan RMSE (Root Mean Square Error) dan nilai R2.
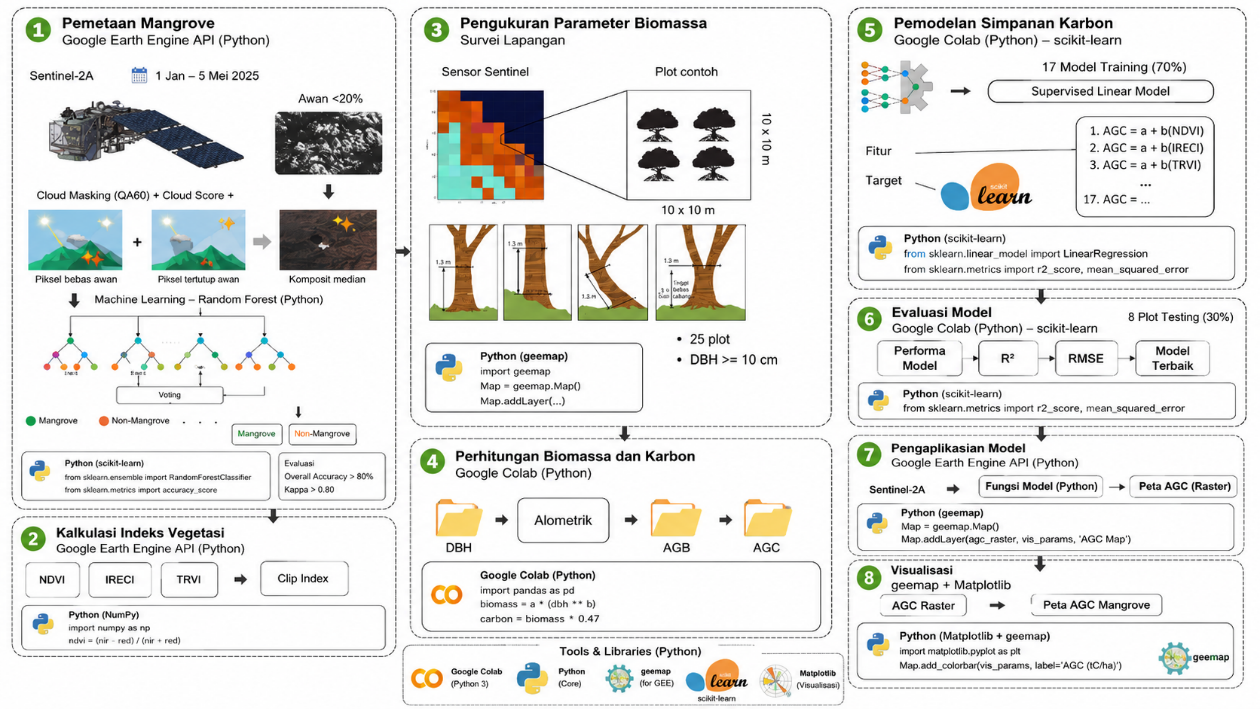
Gambar 3. Desain Penelitian
3.2 Lokasi dan Waktu Penelitian
Penelitian ini dilaksanakan di hutan mangrove muara sungai Cipunegara, yang terletak di Desa Patimban, Kecamatan Pusakanagara, Kabupaten Subang, Provinsi Jawa Barat pada tanggal 23-29 April 2026. Peta lokasi penelitian tersaji pada gambar 4.
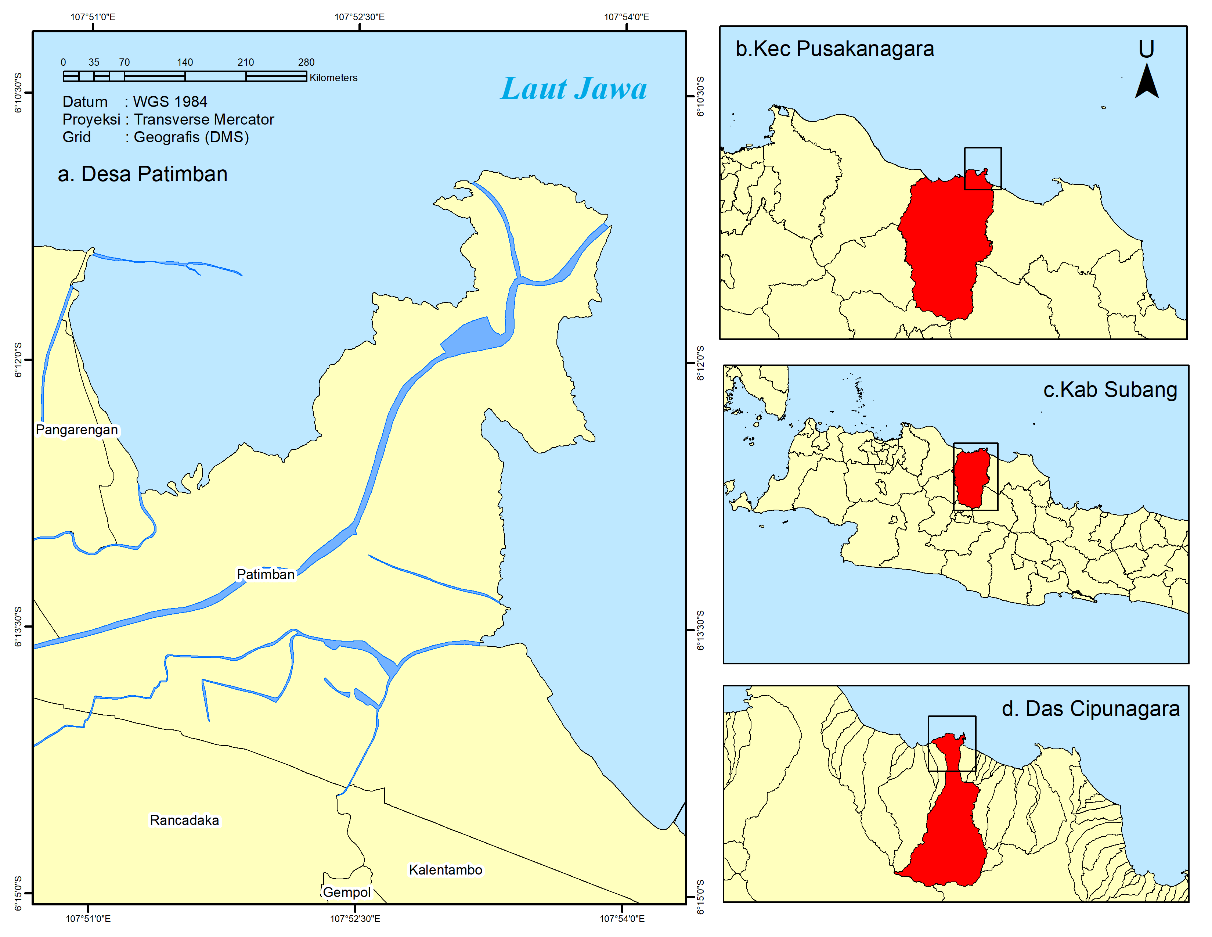
Gambar 4. Peta Lokasi Penelitian
3.3 Populasi dan Sampel Penelitian
Populasi pada penelitian ini adalah mangrove sejati yang tumbuh di muara sungai Cipunegara berdasarkan hasil klasifikasi Sentinel 2A pada komposit multitemporal 1 Januari -5 Mei tahun 2026 dengan resolusi spasial pada unit minimum 10 x 10 meter. Sampel pada penelitian ini merupakan diameter setinggi dada (DBH) mangrove pada lingkar >10m yang diambil sebanyak 25 petak ukur secara acak.
3.4 Definisi Operasional Variabel
Variabel Bebas
Variabel bebas dalam penelitian ini adalah nilai indeks vegetasi, yang diperoleh dari citra satelit Sentinel-2A. Indeks yang digunakan meliputi NDVI (Normalized Difference Vegetation Index), IRECI (Inverted Red-edge Crollophyl Index), dan TRVI (Total Ratio Vegetation Index) , yang masing-masing mencerminkan kondisi kehijauan, kandungan klorofil, serta kepadatan dan struktur kanopi vegetasi mangrove. Nilai indeks ini digunakan sebagai input dalam pemodelan estimasi karbon di atas hutan melalui permodelan regresi.
Variabel Terikat
Variabel terikat dalam penelitian ini adalah simpanan karbon di atas permukaan tanah (Above Ground Carbon) pada hutan mangrove di muara sungai Cipunegara. AGC dihitung dari nilai biomassa hasil pengukuran lapangan menggunakan model alometrik, yang kemudian dikalikan dengan faktor konversi karbon. Nilai AGC inilah yang menjadi parameter utama dalam mengevaluasi akurasi estimasi berdasarkan nilai indeks vegetasi.
3.5 Pengumpulan data
Data yang digunakan dalam penelitian ini terdiri atas data primer dan data sekunder. Data primer meliputi jenis mangrove serta diameter setinggi dada (DBH) pada tingkat pohon yang diperoleh melalui pengukuran pada petak ukur ukur sampel. Data ini digunakan untuk menduga nilai AGB dan simpanan karbon serta validasi model penduga simpanan karbon. Sebaran petak ukur ukur sampel ditentukan berdasarkan tingkat kerapatan vegetasi dengan menggunakan metode random sampling. Pengukuran dilakukan pada 25 petak ukur, yang terdiri atas 17 petak ukur untuk membangun model dan 8 petak ukur untuk validasi model penduga simpanan karbon. Data sekunder yang digunakan adalah citra satelit Sentinel-2A pada rentang temporal 1 Januari-5 Mei 2026 dari Earth Engine Data Catalog yang diakses menggunakan platform Google Colaboratory. Citra ini digunakan untuk memetakan sebaran mangrove dan perhitungan indeks vegetasi sebagai variabel dalam pembuatan model estimasi simpanan karbon.
Pengukuran Biomassa Lapangan
a. Penentuan Sampel Pengukuran
Penentuan jumlah dan sebaran petak ukur sampel pada penelitian ini berlandaskan pada keterwakilan spektral pada indeks vegetasi (Karang et al., 2024; Novanda et al., 2025; Suardana et al., 2023; Thoha et al., 2025). Keterwakilan spektral tersebut direpresentasikan melalui variasi jenis, kerapatan, dan zonasi tumbuh mangrove pada unit terkecil resolusi spasial dan radiometrik citra (Baloloy et al., 2021). Berdasarkan hasil observasi lapangan dan informasi nilai NDVI, mangrove di muara Sungai Cipunegara memiliki tingkat kerapatan yang homogen (0,68--0,99) serta tidak menunjukkan zonasi spesies yang signifikan, sehingga penyebaran sampel dilakukan secara acak. Kondisi ini didukung oleh penelitian Santoso et al. (2026) yang mengklasifikasikan lanskap mangrove muara Sungai Cipunegara ke dalam satu kelas kerapatan dengan homogenitas spesies dan karakteristik pasang surut yang seragam dari empat zona kelas pesisir Kabupaten Subang.
Berdasarkan perbandingan rasio luas wilayah dengan keterwakilan spektral pada sampel penelitian, Santoso et al. (2026) menggunakan 16 petak ukur pada lanskap mangrove muara Sungai Cipunegara, Suardana et al. (2023) menggunakan 40 petak ukur untuk luas 1.130,49 ha di Pulau Benoa Bali, sedangkan Nurdin et al. (2026) menggunakan 15 petak ukur untuk luas 3.165,27 ha di Pulau Nunukan, Kalimantan Barat. Dengan estimasi luas total mangrove sebesar 710,44 ha berdasarkan hasil klasifikasi citra, penggunaan 25 (17 trainning 8 testing) petak ukur dinilai telah memenuhi kriteria untuk pemodelan simpanan karbon mangrove di muara Sungai Cipunegara.
b. Desain Petak ukur
Penelitian ini menggunakan desain petak ukur bujur sangkar dengan ukuran 10 x 10 meter. Petak ukur bujur sangkar berukuran 10 x 10 meter digunakan untuk menyesuaikan bentuk dan ukuran piksel pada citra Sentinel 2A, sehingga total biomassa pada satu petak ukur pengukuran dapat diwakili oleh satu piksel citra (Suardana et al., 2023). Desain petak ukur pengukuran yang digunakan dalam penelitian ini disajikan pada Gambar 1.
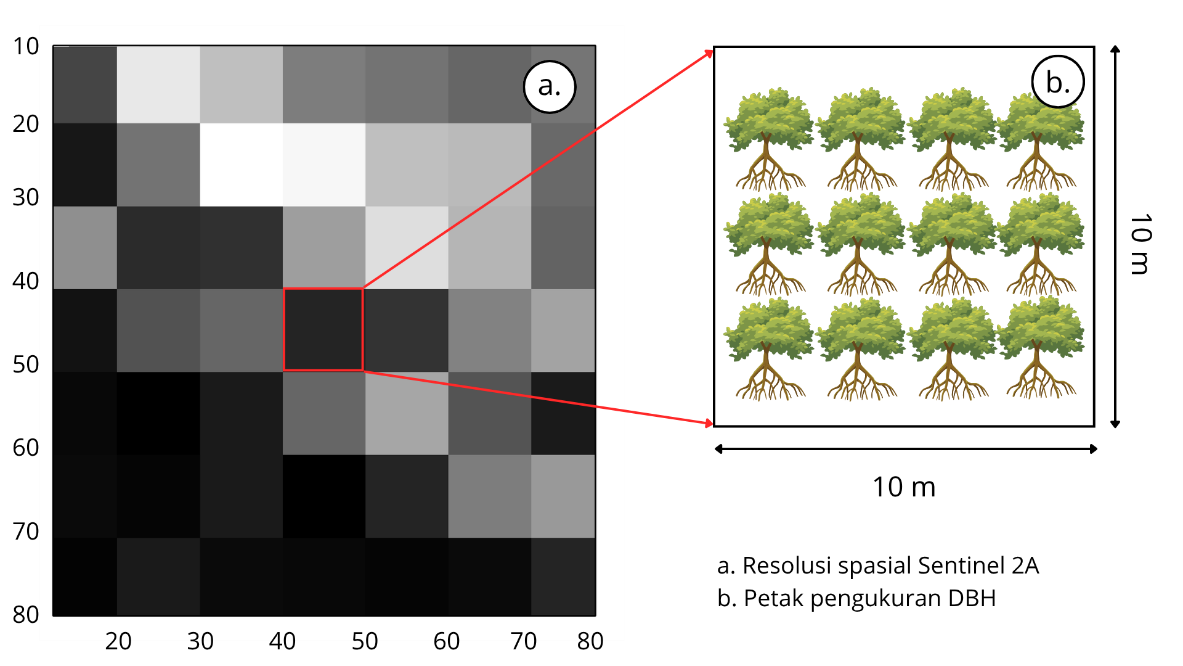
Gambar 1. Desain Petak ukur Pengukuan DBH (Suardana et al., 2023)
c. Parameter Pengukuran Biomassa
Untuk mendapatkan informasi biomassa di atas permukaan, parameter yang diukur adalah DBH mangrove dengan ketinggian 1,3 meter dari permukaan tanah (Suardana et al., 2023b)(Thoha et al., 2025a). Data hasil pengukuran lapangan pada penelitian ini digunakan sebagai data latih sebanyak 17 (70%) petak ukur dan data validasi sebanyak 8 (30%) petak ukur dalam pembangunan model prediksi simpanan karbon mangrove. Pembagian data tersebut dilakukan untuk menghasilkan model yang mampu merepresentasikan hubungan antara variabel spektral citra dan simpanan karbon. Pengukuran vegetasi pada setiap petak ukur difokuskan pada mangrove dengan diameter setinggi dada (DBH) minimal 10 cm karena ukuran tersebut memiliki kontribusi signifikan terhadap estimasi biomassa di atas permukaan tanah (Brown, 2002; Suardana et al., 2013). Menurut Pearson et al (2005) pengukuran DBH dilakukan berbeda untuk setiap batang, sehingga pengukurannya mengacu pada ketentuan seperti yang ditunjukan gambar 5.
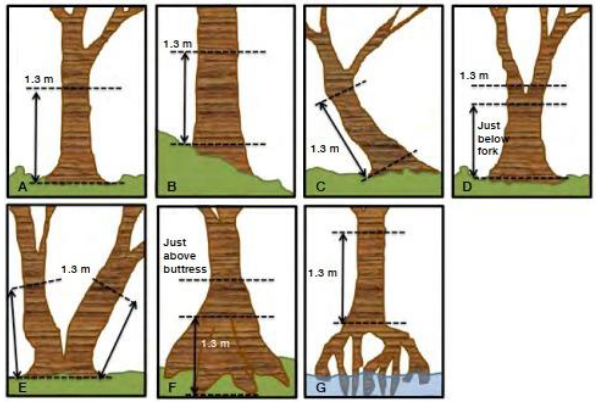
Gambar 5.Ketentuan Pengukuran DBH Mangrove Di Berbagai Kondisi Dan Tipe Vegetasi (Pearson et al., 2005)
3.6 Teknik Analisis Data
Klasifikasi Tutupan Mangrove dan Analisis Indeks Vegetasi
Proses klasifikasi tutupan mangrove dan analisis indeks vegetasi dilakukan menggunakan platform komputasi awan (Cloud Computing) Google Colaboratory berbasis bahasa pemrograman Python. Permrosesan citra satelit dilakukan dengan memanfaatkan Aplication Programming Interface (API) dari Google Earth Engine yang diakses melalui pustaka geemap (Wu, 2020). Klasifikasi tutupan mangrove terdiri dari koreksi awan, klasifikasi citra, dan uji akurasi. Setelah tutupan mangrove dihasilkan, selanjutnya analisis indeks vegetasi dilakukan sesuai tutupan mangrove yang telah dihasilkan.
a. Koreksi Awan (Cloud Masking)
Tahap awal dalam pemrosesan citra pada penelitian ini dilakukan melalui proses penyaringan data berdasarkan rentang temporal 1 Januari hingga 5 Mei 2026 dengan kriteria penyaringan awan 20%. Penyaringan tutupan awan bertujuan untuk memperoleh citra dengan tingkat tutupan awan yang rendah serta menyediakan ketersediaan piksel pengganti yang memadai dalam proses cloud masking (Suardana et al., 2023) . Setelah penyaringan awan dilakukan, tahap selanjutnya adalah proses masking menggunakan algoritma CS + (Cloud Score +). Metode CS + dipilih karena mampu menghasilkan komposit citra dengan tanpa tutupan awan yang akurat dengan rentang temporal yang lebih pendek dibandingkan metode SCL, QA60, Fmask, dan metode masking manual pada nilai digital awan (Pasquarella et al., 2023). Berbeda dengan pendekatan berbasis ambang batas spektral seperti QA60, SCL, maupun Fmask yang memperlakukan kondisi atmosfer sebagai klasifikasi diskret, CS+ memodelkan kualitas observasi sebagai persoalan regresi kontinu. Skor kualitas observasi (Quality Assessment, QA) pada suatu piksel didefinisikan berdasarkan model campuran linear:
Dalam proses melatih model CS+, konsep kesamaan atmosfer antar dua citra (Atmospheric Similarity, ASIM) didefinisikan sebagai:
ASIM antara dua citra pada piksel i sama dengan nilai QA terendah di antara keduanya. Jika terdapat citra referensi bersih r sehingga QA(r)=1, maka , yang memungkinkan estimasi skor QA citra target secara langsung (Pasquarella et al., 2023). Implementasi algoritma CS+ dalam penelitian ini menggunakan pustaka python 3 geemap (Wu, 2020) berbasis kanal cs_sdf yang tersedia pada dataset Cloud Score+ S2_HARMONIZED V1 dengan menerapkan ambang batas sebagai berikut:
Pemilihan ambang batas 0,60 didasarkan pada rekomendasi Pasquarella et al. (2023), di mana threshold ini menghasilkan keseimbangan terbaik antara omission error dan commission error pada dataset validasi Tarrio, dengan nilai F1 tertinggi (0,8466) dan akurasi keseluruhan 0,8096 dibandingkan metode Fmask v4, Sen2Cor, s2cloudless, dan QA60. Setelah masking diterapkan pada setiap citra, komposit piksel terbaik dibentuk menggunakan operator median untuk mereduksi pengaruh nilai ekstrem residual. Hasil komposit kemudian dinormalisasi ke nilai reflektansi permukaan (0--1) melalui pembagian dengan faktor skala 10.000 sesuai konvensi produk Sentinel-2 SR.
Tahap pra-pemrosesan pada penelitian ini tidak mencakup koreksi geometrik maupun radiometrik tambahan karena citra Sentinel-2A telah melalui koreksi sistematis (ESA, 2015). Tutupan awan menjadi faktor penting yang perlu diatasi, karena dapat mengganggu proses klasifikasi dan menurunkan akurasi hasil interpretasi karena objek di bawah awan tidak dapat dikenali dengan baik (Kosasih et al., 2019).
b. Klasifikasi Citra
Klasifikasi citra dilakukan untuk memetakan dua kategori tutupan lahan yaitu mangrove dan non mangrove. Klasifikasi citra dilakukan menggunakan metode terbimbing berbasis algoritma Random Forest (RF) . Algoritma RF dipilih karena dinilai memberikan performa tinggi dalam mengklasifikasikan mangrove dibandingkan algoritma klasifikasi terbimbing lain seperti CART dan Gradient Tree Boosting (GTB)(Simarmata et al., 2025). Pemetaan mangrove ini dilakukan untuk menentukan batas spasial yang akurat, sehingga proses permodelan dan perhitungan indeks vegetasi dapat difokuskan secara spesifik pada wilayah dengan tutupan mangrove (Suardana et al., 2023). Alur proses klasifikasi menggunakan algorima RF dalam klasifikasi mangrove disajikan pada gambar 6.
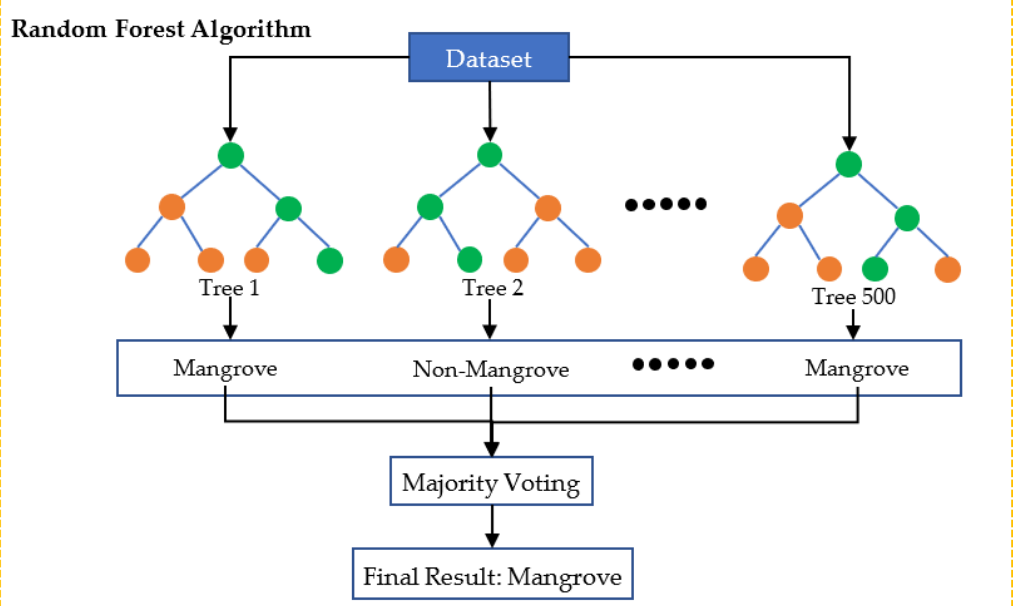
Gambar 6. Algoritma Random Forest dalam Pemetaan Mangrove (Jamaluddin et al., 2022)
Klasifikasi dengan algoritma RF menggunakan semua kanal pada citra Sentinel-2A beserta indeks vegetasi (NDVI, TRVI, dan IRECI) sebagai data input tambahan. Penambahan indeks vegetasi selain kanal asli bertujuan untuk meningkatkan akurasi klasifikasi (Jamaluddin et al., 2022). Model RF dikonfigurasi menggunakan 100 pengulangan pohon keputusan (decision trees), jumlah yang direkomendasikan untuk performa yang baik (Suardana et al., 2023). Selain itu, diatur lima variabel per split, yang mendefinisikan jumlah fitur yang dipertimbangkan pada setiap node (Regier et al., 2023). Untuk melatih algoritma klasifikasi pengumpulan data latih dilakukan dengan mengambil total 200 sampel piksel yang disebar merata ke dalam dua kelas, yaitu 100 titik untuk mangrove dan 100 titik untuk non-mangrove. Titik-titik sampel ditentukan melalui interpretasi visual komposit warna palsu (NIR--SWIR2--Green) pada citra Sentinel-2A, kemudian divalidasi ulang menggunakan citra resolusi tinggi taun terbaru yang tersedia di Google Earth. Penggunaan sampel berbentuk titik (point sample) dipilih karena setiap titik merepresentasikan satu piksel tunggal yang sesuai dengan prinsip kerja algoritma RF yang beroperasi pada tingkat piksel, sehingga dapat menghindari kebingungan algoritma akibat variasi nilai reflektansi dalam satu poligon yang berpotensi menurunkan akurasi klasifikasi (Mahmood et al., 2025).
c. Uji Akurasi Hasil Klasifikasi
Uji akurasi dilakukan untuk mendapatkan informasi dari tingkat presisi suatu hasil klasifikasi (Karang et al., 2024). Pengujian akurasi hasil klasifikasi tutupan lahan menggunakan metode matriks kesalahan atau matriks kontingensi (confusion matrix). Confusion matrix adalah kombinasi berbeda yang digunakan untuk melakukan komparasi antara data hasil pengecekan lapangan sebagai referensi dengan hasil klasifikasi . Perhitungan penilaian akurasi mengacu pada (Congalton & Green, 2009) sebagaimana disajikan pada tabel 4.
| Data Sample | Diklasifikasikan ke kelas | Jumlah | Procedur Acuracy | |||
|---|---|---|---|---|---|---|
| A | B | C | D | |||
| A | Xjj | ... | ... | ... | Xk+ | Xkk/Xk+ |
| B | ... | ... | ... | ... | ... | ... |
| C | ... | ... | ... | ... | ... | ... |
| D | ... | ... | ... | Xkk | ... | ... |
| Jumlah | X+k | X2+ | X3+ | X4+ | N | |
| User Acuracy | Xjj/X+k | ... | ... | ... |
Tabel 4 Perhitungan penilaian akurasi klasifikasi citra
Sumber : Cogalton & Green (2009)
Ukuran keakuratan hasil klasifikasi didasarkan pada overall accuracy dan nilai Kappa, yang ditentukan berdasarkan persamaan sebagai berikut :
Overall Accuracy = x 100%
Keterangan :
X : Jumlah sampel benar pada penggunaan lahan
N : Jumlah keseluruham sampel penggunaan lahan
Akurasi keseluruhan (overall accuracy) menunjukkan prosentase jumlah piksel hasil klasifikasi yang benar berdasarkan data lapangan. Piksel yang dilibatkan dalam perhitungan merupakan piksel yang menjadi sampel. Jika ketelitian lebih dari atau sama dengan 80%, maka hasil klasifikasi dapat diterima.
Keterangan :
K : Koefisien Kappa
N : Jumlah total pengamatan
R : Jumlah baris dalam error matrix
Xii : Jumlah pengamatan baris i kolom i
X1+ : Total pengamatan pada baris i
X+1 : Total pengamatan pada kolom i
Selanjutnya, nilai hasil perhitungan dicocokkan dengan tingkat kesesuaian yang dibuat oleh Landis & Koch (1975) seperti pada Tabel 5.
| Tingkat Kesesuaian | Tingkat Kepercayaan |
|---|---|
| < 0,4 | Rendah |
| 0,5-0,8 | Sedang |
| >0,8 | Tinggi |
| Tabel 5 Tingkat Kepercayaan Hasil Klasifikasi |
Sumber: Landis & Koch (1975)
d. Kalkulasi Indeks Vegetasi
Sebagai variabel input dalam permodelan karbon di atas permukaan, penelitian ini menggunaka tiga indeks vegetasi yaitu NDVI (Normalized Diffrerence Vegetation Index), IRECI (Inverted Red-edge Crolophyll Index), dan TRVI (Total Ratio Vegetation Index) yang tersusun dari kombinasi kanal NIR, Red, dan Red Edge. Pemilihan ketiga indeks ini didasarkan pada hasil penelitian Suardana et al. (2023) dan Thoha et al. (2025), dimana kombinasi dari ketiga indeks tersebut memiliki performa terbaik dalam mendeteksi variasi biomassa mangrove. Hasil ini diperkuat oleh Novanda et al (2025) yang melakukan perbandingan terhadap 32 indeks vegetasi dan menemukan bahwa TRVI termasuk kategori indeks dengan performa terbaik, Karang et al (2024) juga menyatakan IRECI menghasilkan model paling akurat berdasarkan regresi linier sederhana.
| Indeks Vegetasi | Persamaan | Referensi |
|---|---|---|
| NDVI (Normalized Diffrerence Vegetation Index) | (Rouse et al., 1973) | |
| IRECI (Inverted Red-edge Crolophyll Index) | (Clevers et al., 2001) | |
| TRVI (Total Ratio Vegetation Index) | (Fadaei et al., 2012b) |
Tabel 6. Persamaan Indeks Vegetasi dalam Permodelan Karbon di Atas Permukaan
Berdasarkan variabel indeks vegetasi yang digunakan, maka penelitian ini menggunakan empat kanal citra Sentinel 2A yang tersaji pada tabel 7.
| Kanal | Nomor | Panjang Gelombang | Resolusi Spasial |
|---|---|---|---|
| NIR | 8 | 835.1nm | 10 m |
| Red | 4 | 664.5nm | 10 m |
| Red Edge 1 | 5 | 703.9nm | 20 m |
| Red Edge 2 | 6 | 740.2nm | 20 m |
Tabel 7. Kanal Sentinel 2A dalam perhitungan indeks vegetasi
Perhitungan Biomassa dan Karbon di Atas Permukaan
Sebelum memperoleh nilai karbon di atas permukaan (Above Ground Carbon), biomassa di atas permukaan tanah terlebih dahulu dihitung seuai jenis mangrove yang berada pada lokasi penelitian (Suardana et al., 2023). Perhitungan biomassa dilakukan menggunakan model alometrik untuk setiap jenis yang berdasar pada parameter DBH yang diukur di lapangan (Kumar & Mutanga, 2017). Berdasarkan hasil penelitian Sodikin et al (2024), terdapat empat jenis mangrove di Muara sungai Cipunegara diantaranya; Avicennia alba, Avicennia marina, Rhizophora mucronata, Sonneratia alba. Model alometrik yang digunakan untuk menduga biomassa setiap jenis mangrove di muara sungai Cipunegara disajikan pada tabel 8.
| No | Jenis Mangrove | Persamaan Alometrik | Referensi |
|---|---|---|---|
| 1. | Avicenia Alba | W = 0.079211 x DBH 2.470895 | (Sutaryo, 2009) |
| 2. | Avicennia marina | W = 0.1848 x DBH 2.3524 | (Dharmawan & Siregar, 2008) |
| 3. | Rhizophora mucronata | W = 0.128 x DBH 2.6 | (Fromard et al., 1998) |
| 4. | Sonneratia alba | W = 0.0825 x DBH 0.89 | (Kauffman & Donato, 2012) |
Tabel 8. Model Alometrik Jenis Mangrove Muara Sungai Cipunegara
a. Perhitungan Karbon di Atas Permukaan
Untuk menghitung simpanan karbon menggunakan faktor konversi SN1 7724:2011 sebagai berikut:
C = 0.47 x W
Keterangan:
C = Karbon di atas permukaan (Kg)
W = Biomassa (Kg)
0.47 = Faktor koreksi
Berdasarkan persamaan tersebut, nilai biomassa individu pohon dihitung dari DBH yang diperoleh di lapangan. Hasil perhitungan biomassa per pohon kemudian dijumlahkan pada setiap petak ukur untuk memperoleh nilai biomassa total. Setelah itu, karbon di atas permukaan dihitung dari nilai biomassa di atas permukaan berdasarkan aturan yang diterbitkan Standar Nasional Indonesia, (2011) 7724:2011, di mana 0,47 atau 47% biomassa adalah karbon.
b. Perhitungan Total Karbon Petak ukur Pengukuran
Untuk menghitung total karbon pada petak ukur pengukuran menggunakan persamaan SNI 7724:2011 sebagai berikut:
Keterangan:
Cn = kandungan karbon per hektar pada setiap petak ukur (Ton/ha)
Cx = kandungan karbon pada setiap sumber karbon di setiap petak ukur (Kg)
l Petak ukur = luas petak ukur tiap masing-masing petak ukur (m2)
Permodelan Karbon di Atas Permukaan
Model penduga karbon di atas permukaan dibangun dari nilai reflektansi indeks vegetasi dan data hasil pengukuran lapangan (Novanda et al., 2025b). Untuk membangun model penelitian ini menggunakan algoritma pembelajaran mesin linear (Suardana et al., 2023). Pemodelam berbasis pembelajaran mesin linear dilakukan menggunakan pustaka python Scikit learn (Perdegosa et al., 2011). Kombinasi indeks vegetasi dalam input permodelan bertujuan untuk mengurangi kesalahan prediksi (Suardana et al., 2023). Koefisien regresi mengukur besarnya pengaruh nilai indeks vegetasi (X) terhadap variabel terikat (Y), yaitu nilai karbon hasil pengukuran lapangan, dalam model persamaan regresi linier (Karang et al., 2024c). Dalam penelitian ini proses komputasi pemodelan dilakukan menggunakan pada platform google colaboratory.
a. Pembagian Tipe data (Spliting Trainning and Testing)
Pembagian data dilakukan menggunakan fungsi train_test_split pada modul Linnear Regression untuk membagi total 25 petak ukur hasil pengukuran lapangan menjadi dua bagian, yaitu data latih dan data uji dengan rasio 70% dan 30% (Suardana et al., 2023 ; Thoha et al., 2025). Data latih digunakan untuk membangun model regresi agar mampu mengenali pola hubungan antara nilai reflektansi indeks vegetasi dan simpanan karbon, sedangkan data uji digunakan untuk menilai performa model terhadap data yang tidak dilibatkan saat pelatihan (Thoha et al., 2025). Tahapan ini penting untuk meningkatkan kemampuan model serta mencegah terjadinya penyesuaian berlebih (overfitting) (Géron, 2019).
b. Desain pemodelan
Pemodelan berbasis model linear pada pustaka scikitlearn dilakukan menggunakan fungsi Linnear Regression, dengan proses pelatihan dan prediksi masing-masing melalui perintah fit() dan predict(). Pemodelan dibagi ke dalam beberapa kategori, yaitu model tunggal yang terdiri dari indeks red-edge (IRECI) dan non red-edge (NDVI, TRVI), serta model ganda yang mengombinasikan indeks red-edge dan non red-edge (NDVI+IRECI, IRECI+TRVI, dan TRVI+NDVI), sebagaimana disajikan pada tabel 9.
| Komposisi Indeks Vegetasi | Model Regresi |
|---|---|
| Indeks red-edge tunggal | AGC = a+b(IRECI) |
| Indeks non red-edge tunggal | AGC = a+b(TRVI) |
| Indeks non red-edge tunggal | AGC = a+b(NDVI) |
| Kombinasi red-edge dan non red-edge | AGC =a+b1 |
| Kombinasi red-edge dan non red-edge | AGC =a+b1 |
| Kombinasi non red-edge | AGC =a+b1 |
Tabel 9. Komposisi Variabel Permodelan Regresi
Ketarangan:
AGB = Above Ground Biomass (biomassa di atas permukaan tanah)
a = konstanta atau intercept model
b1, b2
c. Evaluasi Model
Karena penelitian ini berorientasi pada pengembangan model prediksi AGC dan kinerja model dievaluasi menggunakan data training-testing melalui nilai R² dan RMSE, maka validitas model lebih ditentukan oleh kemampuan prediksinya dibandingkan interpretasi koefisien masing-masing variabel prediktor. Dormann et al. (2013) menjelaskan bahwa dampak multikolinearitas menjadi lebih kritis pada studi yang bertujuan menginterpretasikan pengaruh variabel. Hal ini sejalan dengan penelitian Latifah et al (2025) dimana selama tiga dekade, estimasi biomassa dan karbon berbasis penginderaan jauh menggunakan nilai R2 dan RMSE dalam mengevaluasi kinerja prediktif model . Model hasil analisis regresi diplikasikan pada 30% (8 petak ukur) data hasil pengukuran yang telah ditentukan untuk mengevaluasi model (Suardana et al., 2023; Thoha et al., 2025). Pemilihan model terbaik dan evaluasi model pada penelitian ini berdasarkan pada hasil uji koefisien determinasi dan galat prediksi dihitung menggunakan RMSE (Maung et al., 2025; Suardana et al., 2023; Thoha et al., 2025) . Perhitungan nilai R2 dilakukan dengan persamaan (Zhang & Fan, 2025) sebagai berikut :
Keterangan :
= nilai karbon hasil pengukuran lapangan
= nilai karbon hasil prediksi model
= nilai rata-rata karbon hasil pengukuran lapangan
= jumlah kuadrat kesalahan prediksi
= jumlah kuadrat total
Validasi dilakukan dengan membandingkan hasil prediksi AGC dari model terhadap sepuluh titik data lapangan yang mewakili subset validasi. Kesalahan prediksi dihitung menggunakan Root Mean Square Error (RMSE), yang dipilih karena mampu memberikan ukuran galat yang stabil tanpa memerlukan nilai mutlak (Suardana et al., 2023). Menurut Zhang & Fan (2025) perhitungan RMSE dapat dilakukan sebagai berikut:
= nilai karbon hasil pengukuran lapangan
= nilai karbon hasil prediksi model
n = jumlah total sampel pengamatan
Secara teknis, perhitungan R2 dan RMSE pada penelitian ini dilakukan menggunakan pustaka Scikit-learn. Koefisien determinasi (R2) dihitung menggunakan fungsi r2_score(), sedangkan nilai RMSE diperoleh melalui fungsi mean_squared_error()(Syam’ani, 2025). Kedua fungsi tersebut digunakan untuk menilai tingkat ketepatan model regresi berganda dalam memperkirakan nilai karbon berdasarkan indeks vegetasi (Suardana et al., 2023). Nilai R2 menggambarkan proporsi variasi data karbon aktual yang dapat dijelaskan oleh model, sementara RMSE menunjukkan besarnya rata-rata penyimpangan antara nilai prediksi dan nilai pengamatan di lapangan (Suardana et al., 2023).
d. Pengaplikasian Model
Setelah model dievaluasi dan dinyatakan persamaan matematis pada model terbaik, tahap selanjutnya adalah pengaplikasian model pada citra satelit. Proses ini dilakukan menggunakan pustaka geemap (Wu, 2020) yang terintegrasi dengan GEE API pada platform google colaboratory untuk menghasilkan model sebaran estimasi simpanan karbon pada area penelitian. Nilai koefisien model yang diperoleh dari hasil pemodelan linear diterapkan pada setiap piksel citra, sehingga setiap piksel merepresentasikan estimasi kandungan karbon di atas permukaan tanah pada ekosistem mangrove. Hasil akhir model kemudian divisualisasikan menggunakan pustaka cartoee dan matplotlib pada ekosistem geemap, sehingga diperoleh peta sebaran karbon mangrove di muara sungai Cipunegara.