30 November 2025 · Terbit pertama di Medium · Semua tulisan
Defani Arman Alfitriansyah
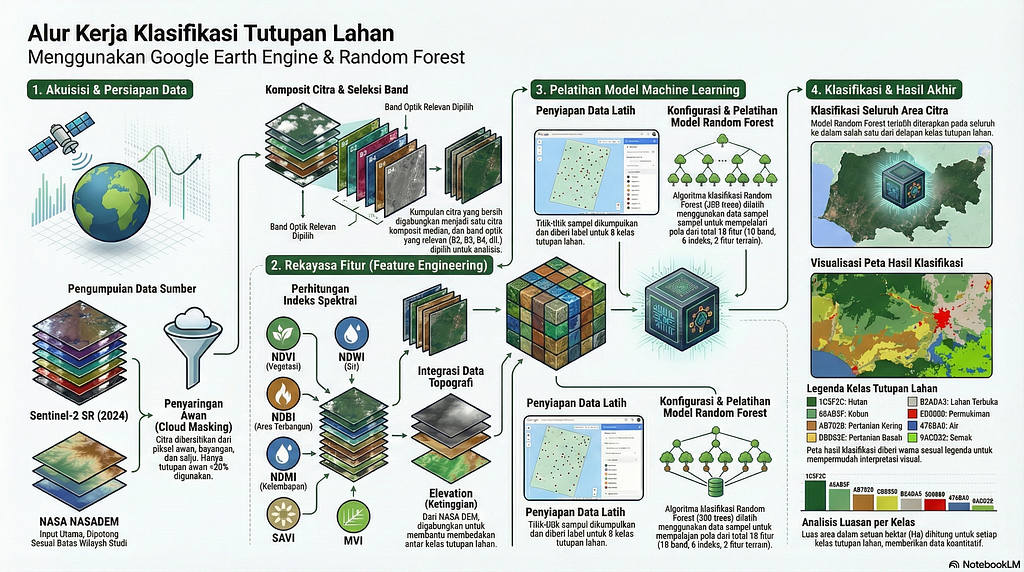
Alur Kerja Klasifikasi Citra (Dibuat menggunakan notebook lm)
A. Pendahuluan
Penginderaan jauh satelit menjadi instrumen utama dalam pemantauan dinamika Land Use and Land Cover (LULC) secara global dan berkelanjutan, karena mampu menyediakan informasi spasial-temporal yang konsisten untuk mendukung pemodelan iklim, pengelolaan banjir, perencanaan kota, dan mitigasi perubahan iklim (Ganjirad & Bagheri, 2024; Gorelick et al., 2017; Alshehri et al., 2025).
Ketersediaan data open-access beresolusi tinggi seperti Sentinel-2 MSI (10–20 m) dan Landsat 8 OLI, dikombinasikan dengan platform cloud computing Google Earth Engine (GEE), telah mengubah cara pengolahan citra skala besar menjadi cepat, murah, dan dapat direproduksi tanpa infrastruktur lokal (Gorelick et al., 2017; Abdollahi et al., 2023; Alshehri et al., 2025). GEE memungkinkan akses langsung ke data surface reflectance yang telah terkoreksi atmosfer serta komputasi paralel skala planet, sehingga menjadi platform dominan untuk pemetaan LULC di berbagai wilayah tropis dan subtropis (Chowdhury, 2023; Sharma et al., 2025).
Awan dan bayangan awan merupakan gangguan utama pada citra optik di wilayah tropis, sehingga langkah cloud masking yang andal menjadi prasyarat mutlak untuk menghasilkan komposit citra berkualitas tinggi (Kosasih et al., 2019). Sentinel-2 menyediakan Scene Classification Layer (SCL) yang secara spesifik mendeteksi awan, cirrus, dan bayangan awan, sehingga memungkinkan pembentukan komposit median tahunan yang bersih. Pengayaan fitur dengan indeks spektral (NDVI, SAVI, NDWI, NDMI, NDBI, MVI) serta integrasi data topografi NASADEM (elevasi dan kemiringan lereng) terbukti sangat efektif meningkatkan separabilitas kelas pada lanskap heterogen seperti daerah aliran sungai, perkotaan, dan perbukitan (Rouse et al., 1974; Huete, 1988; McFeeters, 1996; Gao, 1996; Zha et al., 2003; Buckley et al., 2020; Abdollahi et al., 2023; Sharma et al., 2025).
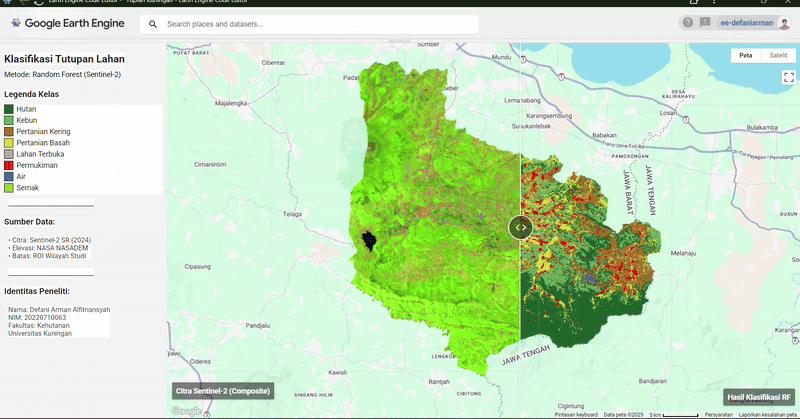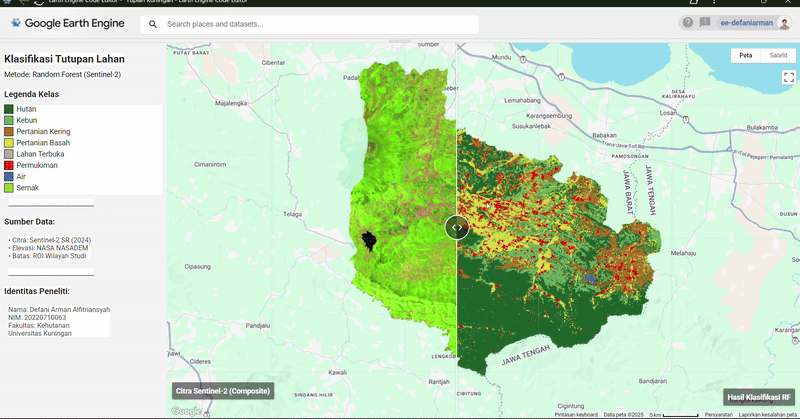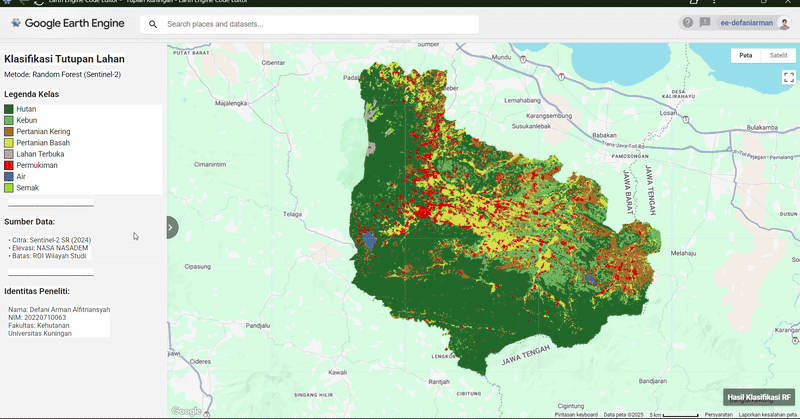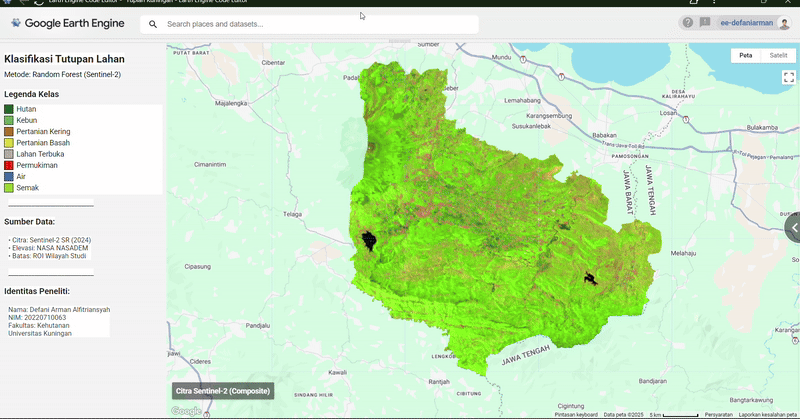
Tutorial ini bertujuan memberikan panduan lengkap dan praktis untuk memetakan LULC menggunakan Sentinel-2 tahun 2024–2025 di Google Earth Engine dengan algoritma Random Forest. Langkah-langkah yang akan dibahas secara berurutan meliputi: cloud masking berbasis SCL, pembuatan komposit median tahunan, perhitungan indeks spektral, integrasi data NASADEM (elevasi dan slope), pelatihan serta penerapan model Random Forest, dan ekspor peta LULC akhir dalam format GeoTIFF siap paka
B. Kajian Pustaka
Random Forest
Algoritma Random Forest (RF) yang diperkenalkan oleh Breiman (2001) merupakan metode ensemble learning berbasis decision tree yang hingga saat ini tetap menjadi salah satu klasifier paling populer dan robust dalam pemetaan tutupan lahan berbasis penginderaan jauh (Belgiu & Drăguţ, 2016; Maxwell et al., 2018). RF bekerja dengan membangun ratusan hingga ribuan pohon keputusan (decision trees) secara paralel, di mana setiap pohon dilatih pada subset acak sampel pelatihan (bootstrap aggregating atau bagging) dan subset acak fitur pada setiap percabangan (random feature selection). Hasil akhir diperoleh melalui voting mayoritas (untuk klasifikasi) atau rata-rata prediksi (untuk regresi), sehingga mengurangi overfitting dan meningkatkan stabilitas model.
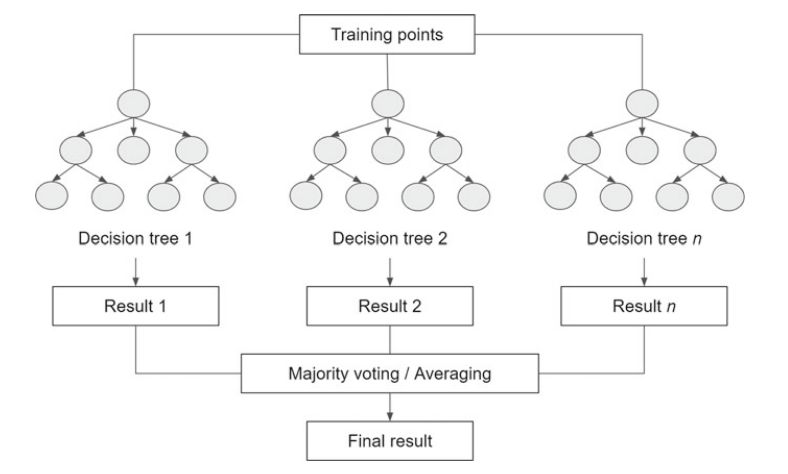
Konsep Algoritma Random Forest (Chardile et al., 2024)
Keunggulan RF dalam konteks klasifikasi tutupan lahan telah terbukti secara konsisten pada berbagai tipe citra dan lanskap. Ganjirad dan Bagheri (2024) menggunakan RF pada Google Earth Engine untuk menghasilkan peta LULC berbasis skema USGS 24-kelas dari citra Landsat 8, menunjukkan bahwa RF secara signifikan mengungguli CART, Gradient Tree Boosting, dan SVM, terutama ketika dikombinasikan dengan pendekatan object-based dan fitur musiman. Sharma et al. (2025) pada citra LISS-4 di wilayah sungai Mahanadi-Shivnath juga menyimpulkan bahwa RF dengan fitur spektral + indeks + topografi memberikan performa terbaik dibandingkan SVM dan Gradient Tree Boosting, khususnya dalam mendelineasi saluran air sempit dan vegetasi jarang.
Studi perkotaan oleh Chowdhury (2023) di Dhaka membandingkan RF, SVM, ANN, dan Maximum Likelihood; hasil menunjukkan RF mencapai overall accuracy 94% dan Kappa 0.91, hanya sedikit di bawah ANN (95% dan 0.93), tetapi jauh lebih stabil dan tidak memerlukan tuning hiperparameter yang rumit. Abdollahi et al. (2023) di Melbourne metropolitan menggunakan RF pada 80 citra Landsat-8 multitemporal di GEE dan mencatat bahwa RF mampu menangani data berdimensi tinggi (spektral + indeks + topografi) dengan baik, menghasilkan overall accuracy 88,47% sebelum post-processing dan meningkat menjadi 92,90% setelah penghilangan salt-and-pepper noise.
Keandalan RF juga terlihat pada aplikasi skala nasional dan global. Meta-analisis oleh Alshehri et al. (2025) terhadap 72 publikasi GEE-LULC (2016–Februari 2025) menunjukkan bahwa Random Forest adalah algoritma yang paling sering digunakan (frekuensi tertinggi bersama SVM), terutama karena kemampuannya menangani data tidak linear, tidak memerlukan asumsi distribusi normal, serta menyediakan informasi feature importance yang berguna untuk interpretasi ekologis.
Beberapa penelitian juga menegaskan bahwa RF relatif tidak sensitif terhadap noise dan ketidakseimbangan kelas, serta memiliki waktu komputasi yang efisien pada platform cloud seperti GEE (Gorelick et al., 2017; Abdollahi et al., 2023). Oleh karena itu, RF dipilih sebagai algoritma utama dalam tutorial ini karena keseimbangan antara performa tinggi, kemudahan implementasi, dan interpretabilitas hasil pada data Sentinel-2 yang kompleks.
2. NDVI (Normalized Difference Vegetation Index)
Normalized Difference Vegetation Index (NDVI) merupakan indeks vegetasi paling fundamental dan paling banyak digunakan dalam penginderaan jauh sejak diperkenalkan oleh Rouse et al. (1974). NDVI memanfaatkan kontras reflektansi yang sangat tinggi antara kanal near-infrared (NIR) dan red pada vegetasi hijau yang sehat, di mana klorofil menyerap cahaya merah secara kuat untuk fotosintesis, sedangkan struktur sel daun menyebarkan cahaya NIR secara intensif. Rumus NDVI adalah sebagai berikut:
NDVI = (NIR − Red) / (NIR + Red)
di mana:
NIR = reflektansi kanal near-infrared (Sentinel-2 Band 8, 842 nm), Red = reflektansi kanal red (Sentinel-2 Band 4, 665 nm)
Nilai NDVI berkisar antara −1 hingga +1. Nilai negatif umumnya menunjukkan permukaan air atau awan, nilai mendekati 0 menunjukkan tanah terbuka atau vegetasi sangat jarang, sedangkan nilai tinggi (0,6–0,9) mengindikasikan vegetasi hijau yang lebat dan sehat (Rouse et al., 1974; Ganjirad & Bagheri, 2024).
NDVI telah terbukti menjadi fitur yang sangat penting dalam klasifikasi tutupan lahan berbasis machine learning. Ganjirad dan Bagheri (2024) menunjukkan bahwa NDVI menjadi salah satu dari tiga fitur terpenting dalam model Random Forest untuk skema USGS 24-kelas. Abdollahi et al. (2023) serta Sharma et al. (2025) juga secara konsisten menempatkan NDVI pada peringkat pertama atau kedua dalam feature importance ketika dikombinasikan dengan indeks lain dan data topografi. Meskipun NDVI dapat mengalami saturasi pada kanopi sangat lebat (LAI > 3) dan sensitif terhadap kecerahan tanah pada vegetasi jarang, kombinasi dengan indeks penyesuai tanah seperti SAVI atau integrasi multitemporal tetap menjadikannya fitur esensial dalam klasifikasi LULC modern (Huete, 1988; Alshehri et al., 2025). Oleh karena itu, NDVI akan selalu disertakan sebagai salah satu band input utama dalam tutorial ini untuk memastikan separabilitas kelas vegetasi yang optimal pada citra Sentinel-2.
TULISAN INI BLM SELESAI TUNGGU PART BERIKUTNYA GESS